Serena MCP を入れても、そのままでは使われない — go-git で実測した話
Claude Code のリファクタリング精度とトークン消費が気になって、Serena MCP を試しました。
結論から書きます。登録しただけでは一度も呼ばれませんでした。 そして呼ばれないまま、grep と同じ間違いをしました。
一方、明示的に指示すると grep が構造的に落とす箇所を正確に拾い、しかも安くて速かったです。これは予想外でした。
n=1 の測定なので参考値として読んでください。追試歓迎です。
Serena MCP とは
oraios/serena は、Claude Code にシンボル単位のコード理解を追加する MCP サーバーです。内部で言語サーバー(Go なら gopls)を起動し、LSP 経由で型情報を解決します。
IDE の「参照を検索」と同じことを、Claude Code から使えるようにするもの、と考えると分かりやすいです。
ネット上には「トークン70%削減」「開発速度3-5倍」といった記事が並んでいます。ただ A/B で測った記事が見当たらなかったので、自分で測ることにしました。
検証環境
- WSL2 (Ubuntu) + VSCode + Claude Code
- モデル: Claude Sonnet 5(両条件で固定)
- Serena: v1.6.0
- 対象: go-git/go-git(690 ファイル)
同一コードを2ディレクトリに複製し、片方にだけ Serena をプロジェクトスコープで登録しました。
cd ~/projects
git clone --depth 1 https://github.com/go-git/go-git.git
cp -r go-git go-git-baseline    # Serena を起動する前にコピーする

cd go-git
claude mcp add serena -- serena start-mcp-server --context claude-code --project "$(pwd)"
--context claude-code は必須です。省略すると desktop-app になり、Claude Code が既に持つツールが重複登録されます。
なお、古い記事にある uvx --from git+https://github.com/oraios/serena ... と --context ide-assistant は現在非推奨です。今は uv でインストールします。
uv tool install -p 3.13 serena-agent
なぜ go-git を選んだか
grep が破綻する条件を探しました。
$ grep -rhoP 'func \(\w+ \*?\w+\) \K\w+' --include="*.go" . | sort | uniq -c | sort -rn | head
     94 Close
     43 String
     40 Next
     30 Decode
Decode だけで 30 個の型が実装しています。さらに *Decoder という同名の型が3つの別パッケージに存在します。
// plumbing/format/idxfile/decoder.go:66
func (d *Decoder) Decode(idx *MemoryIndex) error

// plumbing/format/config/decoder.go:21
func (d *Decoder) Decode(config *Config) error

// plumbing/format/index/decoder.go:81
func (d *Decoder) Decode(idx *Index) error
型名も変数名も同じ。grep では原理的に区別できません。
正解を用意する
gopls references を正解としました。Serena が内部で使うのと同じ LSP なので、フェアな基準になります。
$ gopls references plumbing/object/commit.go:249:20 | wc -l
13

$ grep -rn "\.Decode(" --include="*.go" . | wc -l
253
253 対 13。19倍の乖離です。ここから13件を正確に抜き出せるかが勝負になります。
実験1: Serena なし(grep のみ)
両条件に同じプロンプトを投げました。
plumbing/object パッケージの Commit 型の Decode メソッドについて、
呼び出し箇所をすべて特定して。ファイル・行番号と件数を挙げること。
他の型(Blob, Tree, Tag や各種 Decoder)の Decode と混同しないよう注意。
ファイルは編集しないこと。
結果は 12件。正解は13件なので、1件足りません。
回答の除外リストがこうなっていました。
除外したもの(他の型・関連メソッドとの混同を避けるため確認済み)
- plumbing/object/object.go:223,226,232 → Blob.Decode / Tree.Decode / Tag.Decode
該当箇所を見ると、型スイッチです。
switch obj.Type() {
case plumbing.BlobObject:   ... .Decode(o)   // 223
case plumbing.TreeObject:   ... .Decode(o)   // 226
case plumbing.CommitObject: ... .Decode(o)   // 229  ← これが Commit.Decode
case plumbing.TagObject:    ... .Decode(o)   // 232
}
223・226・232 を挙げながら、その間の 229 だけが抜けています。
grep にはすべて同じ .Decode(o) にしか見えません。229 が Commit のものだと判別するには型情報が要る。構造的な限界がそのまま出ました。
除外リスト自体は丁寧に書かれています。commit_scanner.go の s.c.Author.Decode を Signature.Decode だと正しく見抜いていたりする。それでも型スイッチは越えられませんでした。
この誤りは回答を読んでも気づけません。 丁寧に書かれているぶん、むしろ信頼してしまう。
実験2: Serena を登録した状態(明示指示なし)
同じプロンプトを、Serena 登録済みのディレクトリで実行しました。
結果は 12件。まったく同じ誤りでした。
/context を見て理由が分かりました。
MCP tools · /mcp (loaded on-demand)
  └ 23 tools · 0 tokens
0 tokens。一度も呼ばれていません。
Claude Code はツール定義を遅延読み込みします。使ったときだけ定義が context に載る仕組みなので、0 tokens は「未使用」を意味します。
応答の冒頭も Searched for N patterns, read M files で、標準の Grep/Read しか使っていませんでした。
「他の型と混同しないよう注意」とまで書いても、Serena は選ばれなかったわけです。
実験3: ツール名を明示
プロンプトを変えました。
find_symbol で plumbing/object/commit.go の Commit 型の Decode メソッドを特定し、
find_referencing_symbols で参照元をすべて列挙して。件数も答えて。
ファイルは編集しないこと。
今度は呼ばれました。
Called serena 5 times
そして問題の箇所を検出しました。
plumbing/object/object.go (1件)
- toObject メソッド (line 228)
grep が落とした型スイッチ内の呼び出しです。toObject というメソッド名まで特定しています。
(Serena は「呼び出し元の関数単位」、gopls は「呼び出し行単位」で数えるため、件数は11と13で異なります。取りこぼしではなく粒度の差です。)
コストは?
ここが一番意外でした。
| grep のみ | Serena(明示) | |
|---|---|---|
| コスト | $0.2772 | $0.2210(-20%) |
| API 時間 | 45秒 | 22秒(-51%) |
| cache read | 403.4k | 277.9k(-31%) |
| 会話量 | 8.5k | 9.9k |
| MCP tools | 0 | 2.3k |
精度が上なだけでなく、安くて速い。
「精度と引き換えにトークンを払う」と思っていたので、逆の結果に驚きました。
理由は cache read の差にあります。grep 側は絞り込みのために検索を何度も組み替えて試行錯誤しており、往復が増えていました。Serena は LSP で確定的に答えが出るため5往復で終わっています。
LLM の API はステートレスなので、ツールを1回呼ぶごとに会話全体が再送されます。往復回数がコストに直接掛け算される構造です。ツール定義の 2.3k を払っても、往復削減の方が大きかった。
効果が出なかったケース
先に自作の検証用リポジトリでも測っていました。同名メソッドを4つの型に持たせた Go のコードです。
| grep のみ | Serena 登録 | |
|---|---|---|
| 30ファイル | 14.3k | 13.0k(未使用) |
| 300ファイル | 23.8k | 23.3k(未使用) |
どちらも Serena は呼ばれず、差は誤差の範囲でした。
原因はコードが均質すぎたことです。自動生成した同じ構造のファイルなので、Claude Code は300ファイルあっても2ファイルしか読みませんでした。実際に実行していたコマンドがこれです。
diff <(sed 's/[0-9]\+/N/g' handlers/handler_000.go) \
     <(sed 's/[0-9]\+/N/g' handlers/handler_150.go)
数字を N に正規化して diff を取り、構造が同一なら残りは読まない。合理的です。
「大規模リポジトリほど効果が大きい」とよく言われますが、その前提は「素の AI がファイルを丸ごと何度も読み込む」ことです。規模だけでは条件を満たしません。構造の複雑さが要ります。
使われたかを確認する方法
今回いちばんの教訓です。定期的に確認してください。
1. /context の MCP tools 欄
MCP tools · 23 tools · 0 tokens      ← 使われていない
MCP tools · 23 tools · 2.3k tokens   ← 使われた
これが最も確実です。
2. 応答冒頭のサマリ
Called serena 5 times                              ← 使われた
Searched for 6 patterns, read 1 file, ran 2 shell  ← 標準ツールのみ
3. 回答の書きぶり
Serena が使われた回答は、呼び出し元の関数名・メソッド名を挙げます。grep ベースは行番号とコード断片の羅列になります。
まとめ
- Serena の能力は本物。grep が型スイッチで落とす箇所を正確に拾った
- 条件が揃えば安くて速い。往復が減るため、精度とコストが両立する
- ただし明示指示しないと呼ばれない。4回試して4回とも grep が選ばれた
- 使われなかったことに気づけない。誤答は自信を持って提示される
- 均質なコードでは効果が出ない。規模より構造の複雑さが条件
導入コストはゼロ(登録しても起動時 context は 1 トークンも増えない)なので、入れて損はありません。ただし入れただけでは何も起きない。プロンプトで Serena に言及するか、CLAUDE.md に使用条件を書いておく必要があります。
私の場合、CLAUDE.md にこう書いています。
## Serena の使用条件

以下のときは Serena のシンボル系ツールを使うこと。grep で代替しない。

- 同名のシンボルが複数の型に存在し、grep で区別できない参照調査
  → find_symbol + find_referencing_symbols
- 型スイッチ内・インターフェース経由の間接呼び出しを含む影響範囲の特定
  → find_referencing_symbols
- インターフェースの実装を列挙する必要があるとき
  → find_implementations

上記以外は Grep/Read を使う。
対象ファイルのパスが分かっているなら relative_path を明示すること。
追記(2026-08-02)その1: ツール名まで書く必要はなかった
本文では find_symbol / find_referencing_symbols とツール名を明示しましたが、「Serena を使って」と一言添えるだけでも同じ精度が出ました。
Serena を使って plumbing/object/commit.go の Commit 型の Decode メソッドの
参照元をすべて列挙して。件数も答えて。ファイルは編集しないこと。
| Serena 未言及 | 「Serena を使って」 | ツール名明示 | |
|---|---|---|---|
| 呼ばれたか | なし | あり | あり |
| Serena 往復 | — | 5回 | 4回 |
| コスト | $0.2772 | $0.2344 | $0.1990 |
| API 時間 | 45秒 | 23秒 | 21秒 |
| cache read | 403.4k | 293.2k | 172.3k |
| 精度 | 12件・取りこぼし | 13件・正確 | 13件・正確 |
分かれ目はツール名の有無ではなく、プロンプトに「Serena」という語が含まれるかどうかでした。呼ばれなかった元のプロンプトを見返すと、Serena に一度も言及していません。
23個あるツール名を覚える必要はなく、「Serena で調べて」で足ります。ただしツール名まで書くと探索の初手が確定するぶん、さらに2割ほど安くなりました。精度が目的なら前者、トークンも詰めたいなら後者という使い分けになりそうです。
追記(2026-08-02)その2: onboarding は必要か
Serena の解説記事では「onboarding をやらないとバリバリ動かない」と書かれていることがあります。本記事の検証は onboarding 未実施の状態で行っていたので、実施後に同じ測定をしてみました。
check_onboarding_performed を実行して。未実施なら onboarding も実施して。
実行に 36.7k トークン・4分1秒かかりました。生成されたのは6ファイル 8.4KB。
conventions.md         2242
memory_maintenance.md  2043
core.md                1487
suggested_commands.md   987
task_completion.md      910
tech_stack.md           753
中身はリポジトリ構成、ブランチ方針、lint/test コマンド、コミット規約、完了チェックリストでした。参照調査に使う情報ではありません。
| onboarding なし | onboarding あり | |
|---|---|---|
| Serena 往復 | 5回 | 4回 |
| コスト | $0.2210 | $0.1990 |
| API 時間 | 22秒 | 21秒 |
| 精度 | toObject 検出 | toObject 検出 |
精度は変わらず、往復1回の差は誤差の範囲でしょう。
重要なのは、次のセッションの起点で Memory files が 381 tokens のまま変わらなかったことです。Serena の memories は Claude Code の memory 系統とは別で、必要なときに read_memory で明示的に読む設計のようです。定常コストはゼロでした。
つまり onboarding は「やっても損しないが、参照調査の精度には効かない」。シンボル解決を担っているのは .serena/cache(536KB)の方で、memories はプロジェクトの流儀を記録するものです。役割が違います。
「このプロジェクトの規約に沿って実装して」のようなタスクでは活きるはずですが、そちらは未検証です。
追記(2026-08-02)その3: Serena を使わない方がいいケース
ここまで読んで気づかれたかもしれませんが、本記事の検証には設計上のバイアスがあります。
「grep が破綻する条件」を意図的に探して go-git を選び、Decode(30実装・同名型3つ・型スイッチあり)を狙い撃ちしました。Serena が勝つように仕組んだ土俵です。
そして「Serena を使って」と書けたのは、私が事前に正解を知っていたからです。実務では逆で、「これは grep で足りるのか、Serena が要るのか」を判断できないところから始まります。
公平を期すために、Serena が足かせになる場面も挙げておきます。
Serena が不向きなケース
- シンボル名が分かっていない探索 — 「認証まわりがどこにあるか調べて」のような曖昧な調査。Serena は木構造を降りる往復が必要で、全文検索の方が速い
- 型を持たない対象 — エラーメッセージ、設定キー、SQL 文字列、コメント、ログ出力。
grep "connection refused"の方が確実 - 横断的な把握 — 「TODO コメントを全部集めて」「deprecated が付いている関数」
- 単一ファイル内の修正 — 往復のぶん純粋な無駄
- 新規実装 — 既存コードの参照調査が発生しない
- 言語サーバーが効かない領域 — テンプレート、設定ファイル、ビルドタグで除外される部分
実際、自作の均質なリポジトリ(300ファイル)では Serena は呼ばれませんでしたが、それが正解でした。Claude Code は sed で正規化した diff を取って「全ファイル同一構造」を確認し、2ファイルだけ読んで済ませています。300回の参照検索を回していたら確実に高くついていました。
「呼ばれない」こと自体は失敗ではありません。 問題なのは、grep では区別できない場面で呼ばれないことです。
そして正直に書くと、「その場面かどうかをタスク開始時に判断する方法」は分かっていません。事前にメソッド名の重複を数えておく(後述)程度が限界で、作業中にリアルタイムで判断する術は今のところ見つけられていません。ここは未解決の課題です。
CLAUDE.md に「常に Serena を使え」と書くのは避けた方がいいと思います。往復が増えるだけの場面が確実にあります。
自分で試すには
導入判断の前に、対象コードベースで同名メソッドの重複を数えてみてください。
grep -rhoP 'func \(\w+ \*?\w+\) \K\w+' --include="*.go" . | sort | uniq -c | sort -rn | head -20
同じメソッド名が5つ以上の型に現れているなら、Serena の出番があります。1〜2件なら grep で区別できるので不要でしょう。
さらに、grep と gopls の乖離を測るとインパクトが分かります。
grep -rn "\.MethodName(" --include="*.go" . | wc -l
gopls references ./path/file.go:LINE:COL | wc -l
この差が、そのまま grep の誤差です。
繰り返しになりますが、各条件1回ずつの測定です。LLM の応答には揺らぎがあるので、数値は参考程度に見てください。同じ手順で測れるので、追試して結果が違ったら教えていただけると嬉しいです。
参考
Windows Server 2025の.NET Frameworkのサポートについて
注意
正式な情報ではありませんので取り扱いにご注意ください。
先日Windows Server 2025のInsider Previewがリリースされました。
過去の資産を多数保有している企業では.NET Frameworkをベースに開発されたシステムも多くありますので、.NET Frameworkのインストール状況を確認しました。
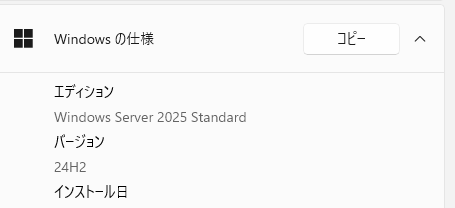
仮想環境にインストールし、システムのバージョン情報を確認します。
確かにWindows Server 2025です。
手っ取り早くレジストリでバージョンを確認します。

Releaseが533320であることがわかります。
以下の情報からインストールされているバージョンは4.8.1のようです。
インストールされている .NET Framework バージョンを確認する - .NET Framework | Microsoft Learn
現状 4.8.1の終了日は未定ですが、最新のOSのサポート期限までは維持されることを考えると、Windows Server 2025のサポート期限まではサポートされるされるのではないか、と推測されます。(現状はWindows Server2022の期限である2031年10月14日までは確実でしたが、もう少し伸びる?)
Microsoft .NET Framework - Microsoft Lifecycle | Microsoft Learn
Windows Server 2022 - Microsoft Lifecycle | Microsoft Learn
まあ何時までも.NET Frameworkにしがみつくのではなく、.NETに移行すべきですが・・・
また当情報はPreview情報ですので、正式リリース時には.NET Frameworkがインストールされていない(サポートされていない)可能性もなきにしもあらず・・・
イヤホンカバー
背景
先日BOSEのオーバーイヤーヘッドフォンを購入したのですが
想定通りというか、長時間つけていると熱くなります。
いつの日か売却する際にきれいな方がよいなぁということで
イヤホンカバーを購入することにしました。
購入したもの
イヤホンカバーといえば定番のmimimamoさんのカバーです。

買ってみての感想
- 装着はかんたん
- 音質は特に落ちた感じはしないです。キャンセル感も特に違和感なく
- サラサラしていて良い感じ
- デメリットとしては当然ボタンが隠れるので探しづらい。充電のときにカバーを外す必要があります。まあ外すのかんたんですけど
- 見た目的には微妙ですが外に持っていくことはないし、持っていっても本体と同じ黒なので良いかしらと。
子供とともに使うタブレット選び
なぜタブレット
子供にパソコンを時間制限で使わせているのですが、最近在宅勤務で私がパソコンに向かっている時間が多くなって、パソコンを使わせることができていないです。スマホとかも画面が小さく子供がYoutubeでずーっと向くのにはむかないし、学校でパソコンとかタブレットが必要になってきたので、タブレットが必要かな、と
今まで使っていたタブレット
第3世代のiPadを使っていましたが、バッテリが持たない、すごく遅くなっていたので最近は押入れにしまって使ってません。
なぜiPadではないの?
以前もiPadを使っていたので、今回もiPadと思っていたのですが、子供とアカウント共有するのが嫌だなーと思いって、マルチユーザに対応しているAndroidにしようと思いました。
罠1
Androidタブレットを選ぼうと思っていたのですが、そもそもAndroidタブレットが最近新機種がでていない。タブレットは押していない様子。
罠2
Androidタブレットであれば5.0からマルチユーザに対応している、と思っていたので全タブレットが対応していると思い、Huaweiを購入しようと思っていましたが、色々調べてみると、結構マルチユーザに対応していないことがわかりました。謎。Fire HD10を購入して、Google Playを入れようと思ってたのですが、マルチユーザに対応していないのであれば買っても意味がな~い。

HUAWEI MediaPad T5 10 タブレット 10.1インチ Wi-Fiモデル RAM2GB/ROM16GB ブラック【日本正規代理店品】
- 発売日: 2018/09/21
- メディア: Personal Computers
マルチユーザに対応したタブレット

Lenovo Tab P10 10.1型 LTEモデル (Snapdragon 450/4GBメモリー/64GB/スパークリングホワイト)ZA450140JP
- 発売日: 2018/12/07
- メディア: Personal Computers

NEC 10.1型タブレットパソコン LAVIE Tab E TE510/HAW(Microsoft Office Mobile) PC-TE510HAW
- メディア: Personal Computers
このあたりでした。
結局選んだのは
色々見ていましたが、最終的にはsoftbankで販売しているlenovo Tab5を購入しました。P10とほぼ同じ機能を持っていますが、OSがAndroid9で最新でかつ中古ショップで安く購入できそうだったからでございます。LTE対応モデルですが、SIMロックを解除されておらず、解除してもLTEのバンドがSOFTBANK向けで、DOCOMOやAUはそんなに向いていないっぽいし、外で使うこともないので気にしないことにしました。
iPhone売却時の注意点
ヘッドフォンカバー
先日オーバーイヤー(アラウンドイヤー)タイプのヘッドフォンを買いました。
オーバーイヤータイプは結構汗が気になるので
対策ということでカバーを購入します。
感想は買ったあとで。
ヘッドフォン選び
目的
最近在宅勤務で音楽を聞いていることが多いので、聞きやすいヘッドフォンを選びたい
候補
WH-1000XM3
定番ですね。選んで失敗することなさそう。
ただGW前で在庫少ないところが多い。
複数台つなぐときが面倒な様子。
充電はType-C

ソニー SONY ワイヤレスノイズキャンセリングヘッドホン WH-1000XM3 B : LDAC/Bluetooth/ハイレゾ 最大30時間連続再生 密閉型 マイク付 2018年モデル ブラック
- 発売日: 2018/10/06
- メディア: エレクトロニクス
-
BOSE NCH 700
ソニーのものに比べてNCの機器が穏やか
2台切り替えが楽。iPhoneとパソコンとか
値段が高いのがデメリット
充電はType-C

BOSE NOISE CANCELLING HEADPHONES 700 ワイヤレスノイズキャンセリングヘッドホン Amazon Alexa搭載 トリプルブラック
- 発売日: 2019/09/12
- メディア: エレクトロニクス
- Boase QuietComfort 35
これも2台つなぎやすい
装着感が良いとのこと。
ちょっと古めの機種ですね。評判はすごく良いです。
充電はmicro-B
質感がNCH700より良い、という声も

Bose QuietComfort 35 wireless headphones II ワイヤレスノイズキャンセリングヘッドホン Amazon Alexa搭載 ブラック
- 発売日: 2017/11/27
- メディア: エレクトロニクス
押しの記事
さあどれを選びましょうか
NC押しの記事
選ぶ際のポイント
- iPhoneとPCを切り替えをしたい
- 仕事をするときに長時間使うのでつけ心地が良いほうが良い。
- 家での仕事なのでそんなにキャンセリングはこだわらない。
- 通話は今ところそんなにしないかな。
- 当然安いほうが良いのだけど
決めたヘッドフォン
BOSEのNCH700
- 2台切り替えが楽
- BOSEのサイトで買うと30日間返品保証
- Yahooで買うと5のつく日はポイント込みで考えると安い。
- 新品の場合QuietComfortと差は少なかった。
届いて使ってみたら感想を上げてみよう
